|
📣 工商時間 很多工程師學了 AI 技術,以為只要接接 OpenAI API、做個向量檢索就是全端 AI 了。但在真實企業場景中,你必須處理資料庫一致性、身分驗證、微服務架構,以及高精確度的檢索控制。 《AI 賦能全端開發:從零打造企業級智慧應用》教的就是這套硬實力: 這期的字幕實驗也一樣:Jev 只判斷哪一刀比較順,失敗了怎麼退、金鑰放哪裡,還是得工程師自己寫好。 |
上一期聊 TypeSafe 的 Jev,整篇都在講 RAG。這期換個方向,講我自己拿它處理的一件雜事。
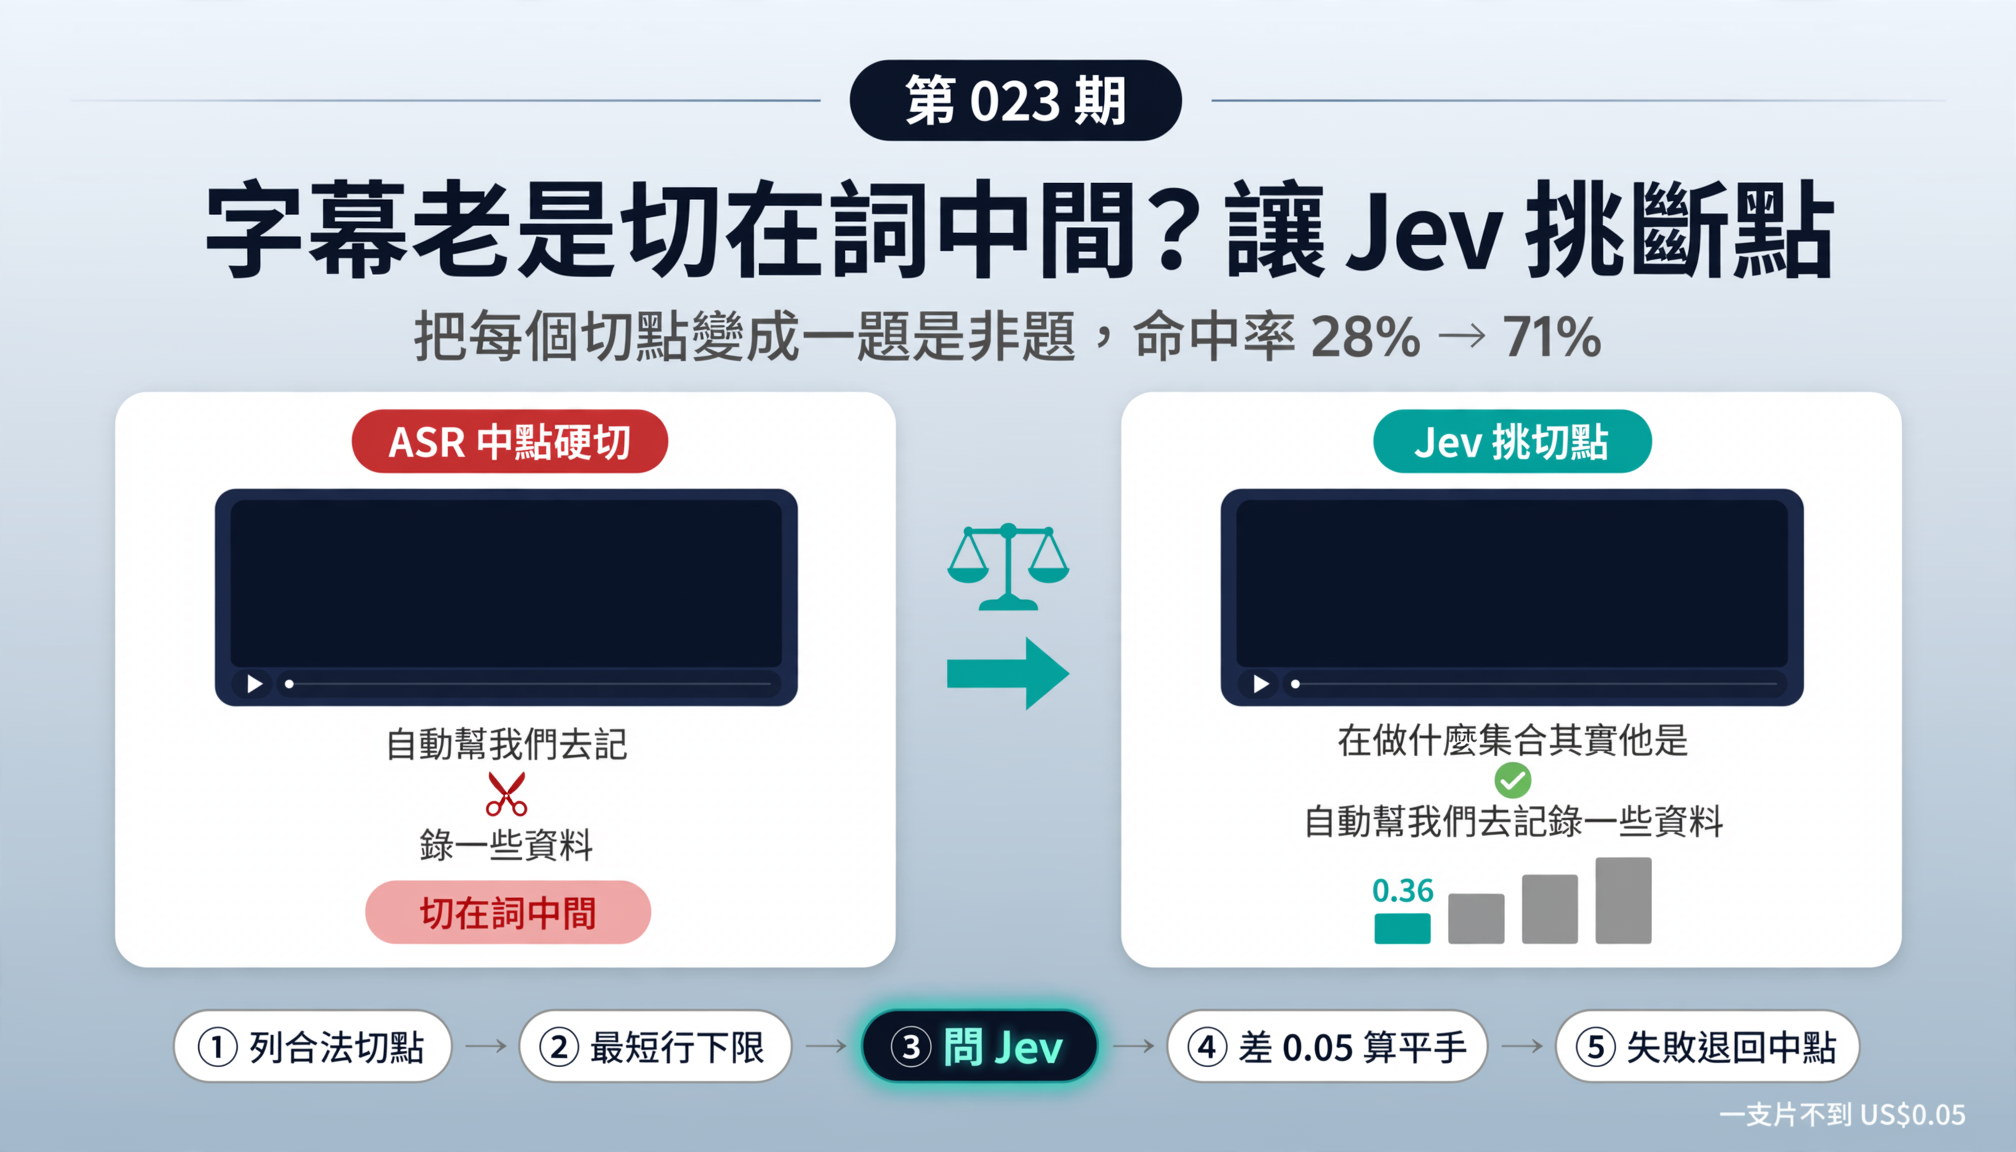
剪講課影片時,我最常做的雜事之一是修 ASR 的斷行。句子一超過 20 個字,ASR 就在最接近中間的地方切成兩行,常常切在詞中間,像「去記錄|一些資料」「建立|日期」。以前我都是一句一句選字、按「移至下句」手動搬。
後來我改成把每個候選斷點當成一題是非題丟給 Jev,挑它覺得最不會拆開詞組的那一刀。拿我自己的課程字幕測,切在我手動保留位置的比例從 28% 變成 71%。
過程中我先用錯了問法,那一段也照實放進來,兩種問法擺在一起看,差別很明顯。
① 準備:Jev 能做什麼、怎麼呼叫
Jev 是 TypeSafe 的 System One 模型。它不會寫字,只會回答判斷題,給你一個機率。所以別指望它幫你改錯字,但「這裡斷行好不好」這種題目,它剛好擅長。
| 項目 | 內容 |
|---|---|
| 端點 | POST https://api.typesafe.ai/v1/systemone,Authorization: Bearer <金鑰> |
| 模型 | jev-latest(撰文時為 1.13.0) |
| 題型 | noul(是非題,回 0~1)、choice(多選一)、score(分級) |
| 費用 | 只算輸入 token,每百萬 0.042 美元;輸出免費 |
| 上限 | 單次 64k token、每分鐘 1,200 次請求 |
| 中文 | 可用,但官方說明準確度低於英文,要用自己的素材實測 |
一次請求可以帶好幾題,Jev 會平行作答。最小的呼叫長這樣,Python 標準庫就夠了:
import json
from urllib.request import Request, urlopen

def call_jev(key, state, questions):
    """送出一次 System One 請求,回傳 answers(題目 id → 答案)。"""
    body = json.dumps({"state": state, "model": "jev-latest", "questions": questions},
                      ensure_ascii=False).encode("utf-8")
    req = Request("https://api.typesafe.ai/v1/systemone", data=body,
                  headers={"Authorization": "Bearer " + key, "Content-Type": "application/json"})
    with urlopen(req, timeout=30) as r:
        return json.loads(r.read())["answers"]
noul 題的回答是 {"type": "noul", "noul": 0.78},數字越接近 1 代表越接近「是」。後面的示範都用這個函式。
② 示範一:一次選一個切法(失敗的問法)
我第一個想到的做法,是把所有切法列成選項,讓 Jev 用 choice 挑一個。結果在四個我手動修過的錯斷上,它一個都沒挑中。
criteria = {f"c{k}": f"前一行「{''.join(words[:k])}」/後一行「{''.join(words[k:])}」"
            for k in cuts}
questions = {"cut": {
    "type": "choice",
    "instructions": "這是中文講課影片的口語逐字稿,一段字幕太長必須斷成兩行。"
                    "選出讓前後兩行各自語意完整的斷法。",
    "criteria": criteria}}
| 指標 | 結果 |
|---|---|
| 選中我手動修正的位置 | 0 / 4 |
| 信心(confidence) | 0.27~0.69 |
回頭看原因:十幾個選項裡常有好幾個都算通順,機率就被攤平了。我真正在意的只有「這一刀有沒有拆開詞組」,多選一的問法沒把這件事問出來。多選一比較適合選項彼此差很多的分類題。