工商時間選型、模組拆解、里程碑與驗收標準——這些設計期的功夫,課程裡是拿一整套企業級專案從頭做給你看的。 《AI 賦能全端開發:從零打造企業級智慧應用》:用同一套 AI CRM 專案,從 Spring Boot 後端、React 前端到資料庫與權限,一路加上 Spring AI、RAG 與 AI Agent,完成真正能上線的企業級應用。 |
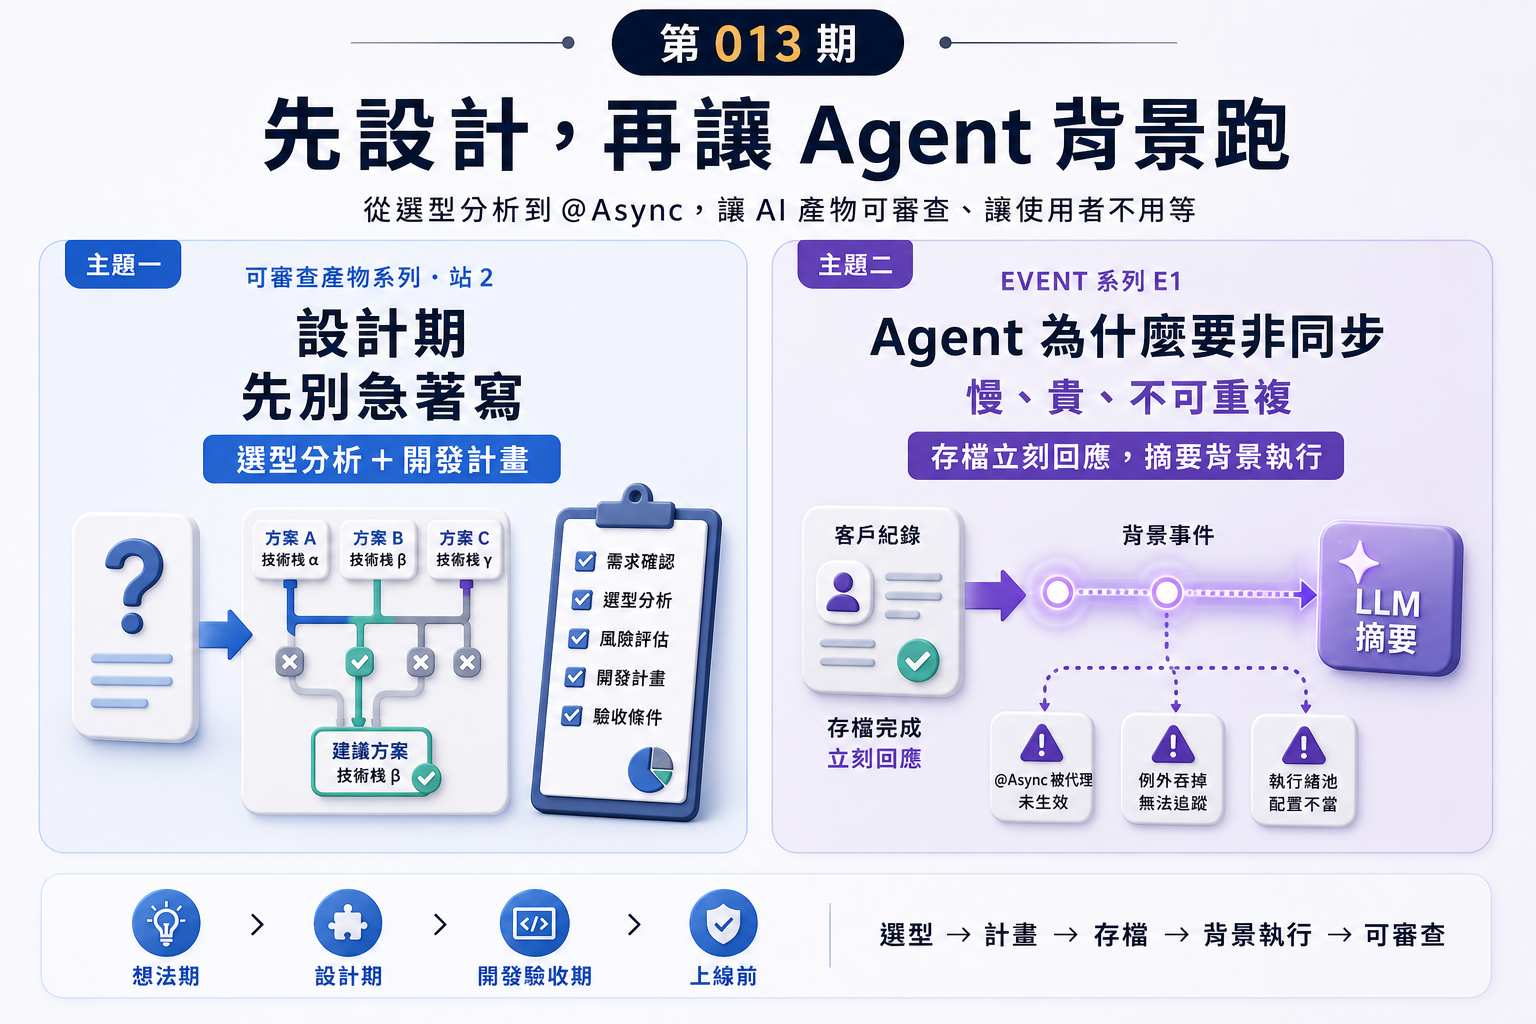
主題一|設計期:先別急著寫——可審查產物系列・站 2
嗨,我是凱文大叔。
上期在想法期把「能不能做」換成了可行性評估報告。這期進第二站:設計期——你確定要做了,但還沒開始寫。
一句話裡藏的決定
❌ 別說:「幫我用 React 寫一個報修系統。」
這句話有一個很隱密的問題:你已經幫它決定了技術棧,而你憑什麼確定 React 是對的?也許這個工具只有你一個人用、畫面只有三頁、資料量三百筆——一個純 HTML 加一點 JS 就夠了;也許你的團隊全是 Java 人,前端只有一個人扛。
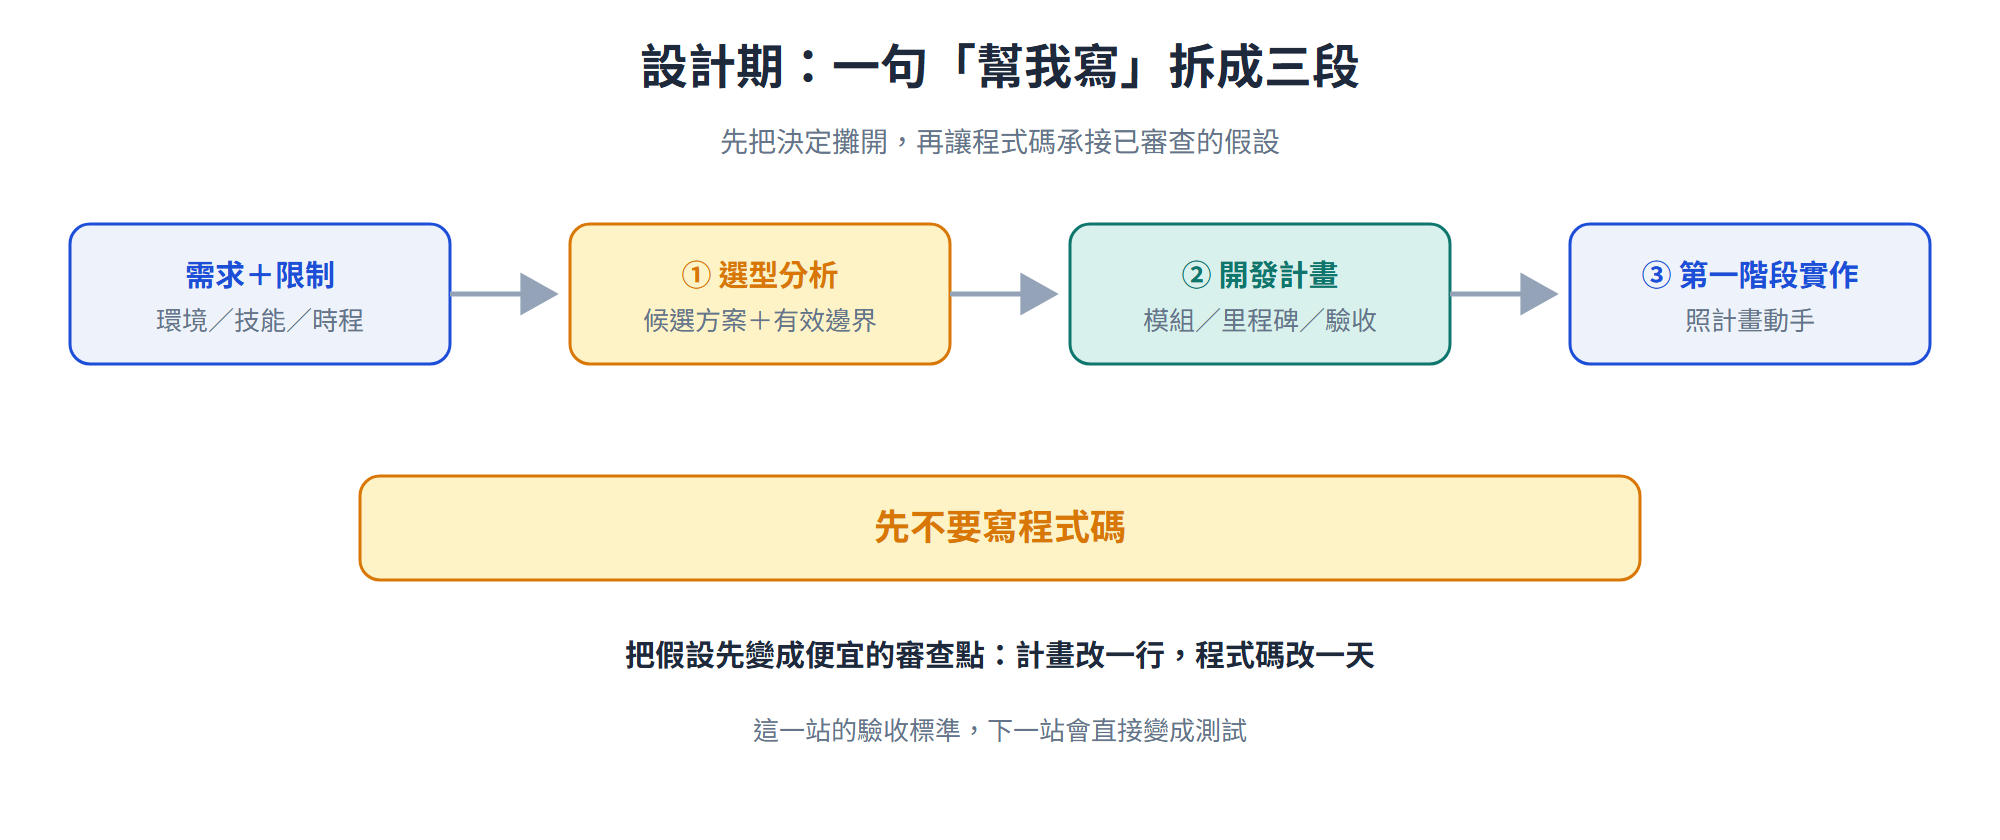
不先分析就點名技術,AI 不會反駁你——它會照做(上期講過的討好傾向,這裡再度登場)。所以設計期的換句話,是一句換三句:
- 先做選型分析:列候選方案、優缺點、適用情境、推薦與理由
- 再寫開發計畫:模組、里程碑、驗收標準——先不要寫程式碼
- 才照計畫實作第一階段
① 選型分析:沒有限制的建議等於沒建議
提示詞全文(可直接複製)
我要做【需求】。我的限制是:
- 開發環境:【例:Windows + PowerShell】
- 團隊技能:【例:熟 Java,前端只有一人】
- 部署環境:【例:公司內網,不能連外】
- 時程與人力:【…】

請列出 2-4 個可行的技術選型方案,每個方案說明:
優點、缺點、適用情境、在我上述限制下的契合度。
最後給出你的推薦與理由,並說明什麼情況下你會改推薦別的方案。
重點在「我的限制是」那四個欄位。不先講限制,AI 會直接套訓練資料裡出現最多次的組合——那是「大家最常用的」,不是「你能用的」。把環境、技能、時程寫進提示詞,等於把驗收條件搬到生成之前——這一招叫約束前置(constraint-first),後面幾站會反覆用到。
最後一句也很關鍵:「說明什麼情況下你會改推薦別的方案。」實際跑出來是這樣:

這張表比推薦本身更重要。它告訴你這個決定的有效邊界:時程放寬到三天以上、這工具要給團隊用、畫面超過八個、資料到數萬筆——任何一條成立,推薦就會變。一個沒有附上邊界條件的建議,你沒辦法判斷它什麼時候會過期。
② 開發計畫:一句一定要加的話
提示詞全文(可直接複製)
採用【選定方案】。請寫一份開發計畫:
1. 模組拆解:每個模組的職責與相依關係
2. 里程碑:分幾個階段,每階段的產出是什麼
3. 每階段的驗收標準:怎樣算做完(要可驗證,不要「功能正常」這種寫法)
4. 風險點與對應的先行驗證

先不要寫程式碼。
「先不要寫程式碼」這句請一定要加。為什麼?因為開發計畫是一個便宜的中間產物——
計畫改一行,程式碼改一天。
計畫寫在紙上,你才看得出它哪裡不準;程式寫完才發現方向錯,成本差一個數量級。沒有這句話,AI 很樂意直接動工,把你還沒審過的假設全部寫進程式碼裡。
另一個重點是第三項驗收標準的寫法:「怎樣算做完,要可驗證,不要『功能正常』這種寫法。」實際產出長這樣:

每一條都能打勾:空專案進度回 0、三個任務完成一個回 1/3、A→B→A 的循環相依被拒絕……「功能正常」四個字你沒辦法審查,這批句子可以。
而且先劇透一件事:這批驗收標準等一下會直接變成測試——下一站你會看到它們一模一樣地出現在測試名稱裡。這就是「可審查產物」會產生的複利:這一站的產物,是下一站的輸入。
站 2 收工
設計期的換句話練習:一句「幫我寫」拆成三句——選型分析逼出有效邊界、開發計畫給你便宜的審查點、然後才動工。外加一句護身符:「先不要寫程式碼。」
下一站是全系列最大的一站:開發驗收期。「幫我測試程式有沒有問題」這句話的毛病在哪?為什麼 AI 寫完程式再補的測試,會變成「證明自己對」的測試?還有一招我覺得整場最划算的——讓測試跑完自己長出一份操作手冊。下期見。
主題二|為什麼 AI Agent 一定要非同步
上期的結論是:Spring 的 publishEvent() 預設是同步的,監聽器跟發布端跑在同一條執行緒上。
那時候留了一個問題沒回答——
AI CRM 的「產生客戶摘要」要呼叫 LLM,一跑就是三十秒。如果監聽器跟發布端同一條執行緒,使用者按下「儲存客戶資料」之後,畫面就得轉三十秒的圈圈。
而且問題不只是「久」。
三十秒會引發的連鎖反應
使用者不會乖乖等。他會:重新整理,然後再按一次儲存。
於是第二次請求進來,第二次 LLM 呼叫也開始跑。第一次那個沒有停——它還在別的地方跑著,只是沒人在等它的結果了。
你付了兩次錢,拿到一個沒人要的結果。
更糟的是,這件事有很大機率不是使用者主動觸發的。反向代理有預設逾時(Nginx 常見是 60 秒)、瀏覽器有逾時、前端的 HTTP 客戶端通常也設了重試——這條鏈上任何一環先放棄,重試就自動發生了,使用者甚至不知道自己送出了兩次。
Agent 跟一般 CRUD 不一樣的三件事
一般的 CRUD 操作,同步做完全沒問題:查個資料庫幾毫秒,慢也慢不到哪去。但 Agent 有三個特性,讓「同步」從小缺點變成真問題:
| 一般 CRUD | AI Agent | |
|---|---|---|
| 快慢 | 毫秒級 | 數秒到數十秒 |
| 成本 | 幾乎為零 | 按 token 計費,跑一次付一次 |
| 可重複性 | 重跑結果一樣 | 重跑結果不一樣 |
第三點最容易被忽略。一般的重試是安全的——重算一次總額,答案還是同一個。但 LLM 重跑會給你不同的摘要,於是「重試」不再是無害的補救,而是變成資料不一致的來源。
所以結論很直接:Agent 這類工作,不該讓使用者的請求在原地等它。
要把「更新客戶資料」和「產生 AI 摘要」在時間上切開——前者立刻做完回應使用者,後者自己在背景慢慢跑。
上期我們已經把它們在結構上切開了(事件解耦)。這期補上時間上的那一刀。
