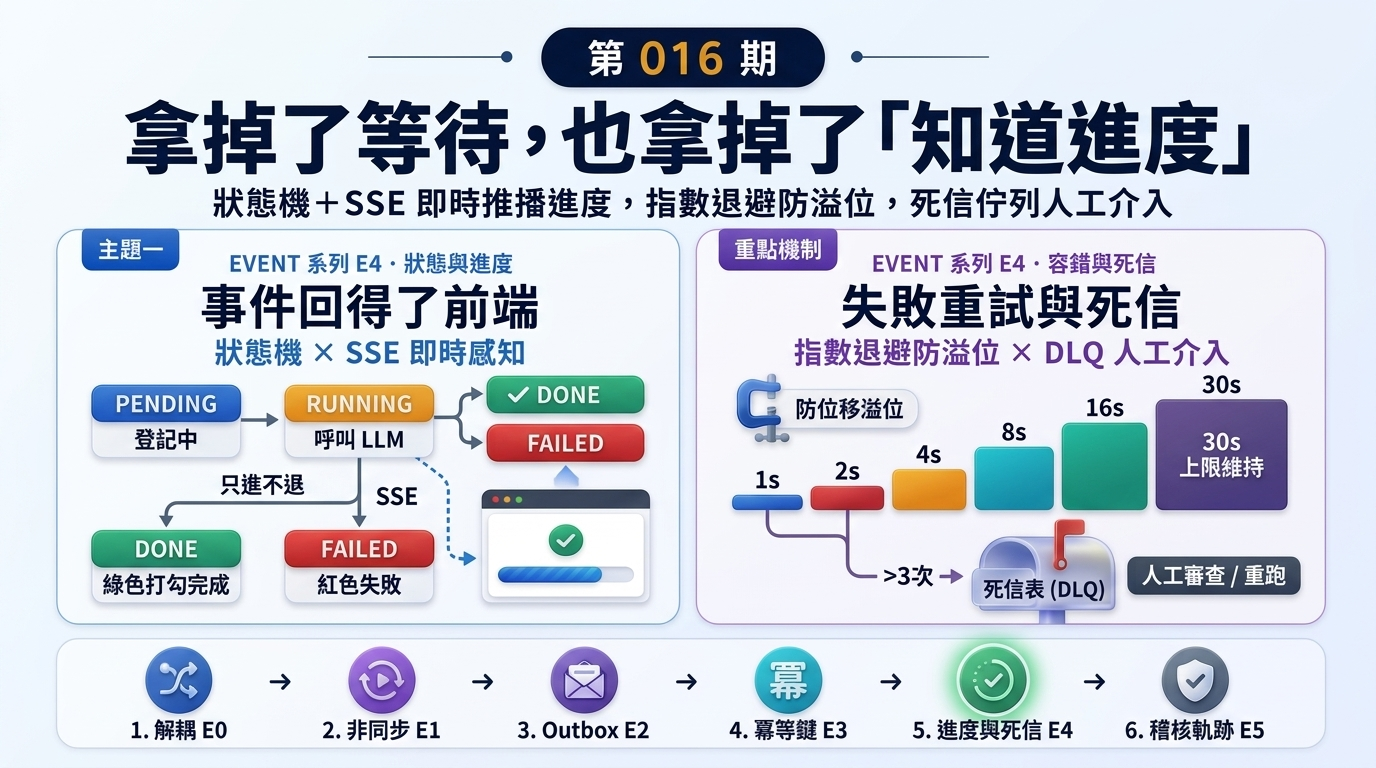
工商時間這個系列講的是「AI 功能上線之後」會遇到的事。而在那之前,你得先有一套真的跑得起來的系統。 《AI 賦能全端開發:從零打造企業級智慧應用》:用同一套 AI CRM 專案,從 Spring Boot 後端、React 前端到資料庫與權限,一路加上 Spring AI、RAG 與 AI Agent,完成真正能上線的企業級應用。 |
事件回得了前端:進度、失敗與死信
前四期把事件的路鋪完了:解耦(E0)、非同步(E1)、送得出去(E2)、收得下來(E3)。
系統現在很穩:存檔立刻回應、交易失敗不會亂送、當機不會遺失、重送不會重跑。
然後你把畫面打開,發現一件事——使用者完全不知道發生了什麼。
按下儲存,畫面立刻回來了。摘要區塊空空的。過三十秒,還是空的(因為前端不會自己重新查)。使用者重新整理一次,摘要出現了。
他不知道要等,也不知道等多久,更不知道到底成功了沒有。
我們拿掉了等待,也拿掉了感知
同步有一個被低估的好處:它的進度回報是免費的。
畫面在轉圈圈,就代表還在跑;轉圈停了、內容出現,就是成功;跳出錯誤訊息,就是失敗。使用者不需要學任何東西就懂。
改成非同步之後,這三件事全部消失了:
| 使用者想知道 | 同步時 | 非同步後 |
|---|---|---|
| 現在在跑嗎 | 看轉圈圈 | 不知道 |
| 成功了嗎 | 內容出現 | 不知道 |
| 失敗了嗎 | 跳錯誤訊息 | 不知道 |
而且第三項最糟:失敗的時候,畫面跟「還沒跑完」長得一模一樣。使用者會一直等一個永遠不會來的東西。
這期就是把這三件事補回來。而且好消息是——上期我們已經把地基打好了。
狀態、進度、放棄
一、狀態機:先讓系統自己知道
上期為了做冪等,我們建了一張表記錄哪些事件處理過。當時多存了幾個欄位,現在派上用場:
create table event_tasks (
    event_id     varchar(64) primary key,
    status       varchar(20) not null,     -- PENDING / RUNNING / DONE / FAILED
    attempts     int         not null default 0,
    last_error   varchar(500),
    updated_at   timestamp   not null
);
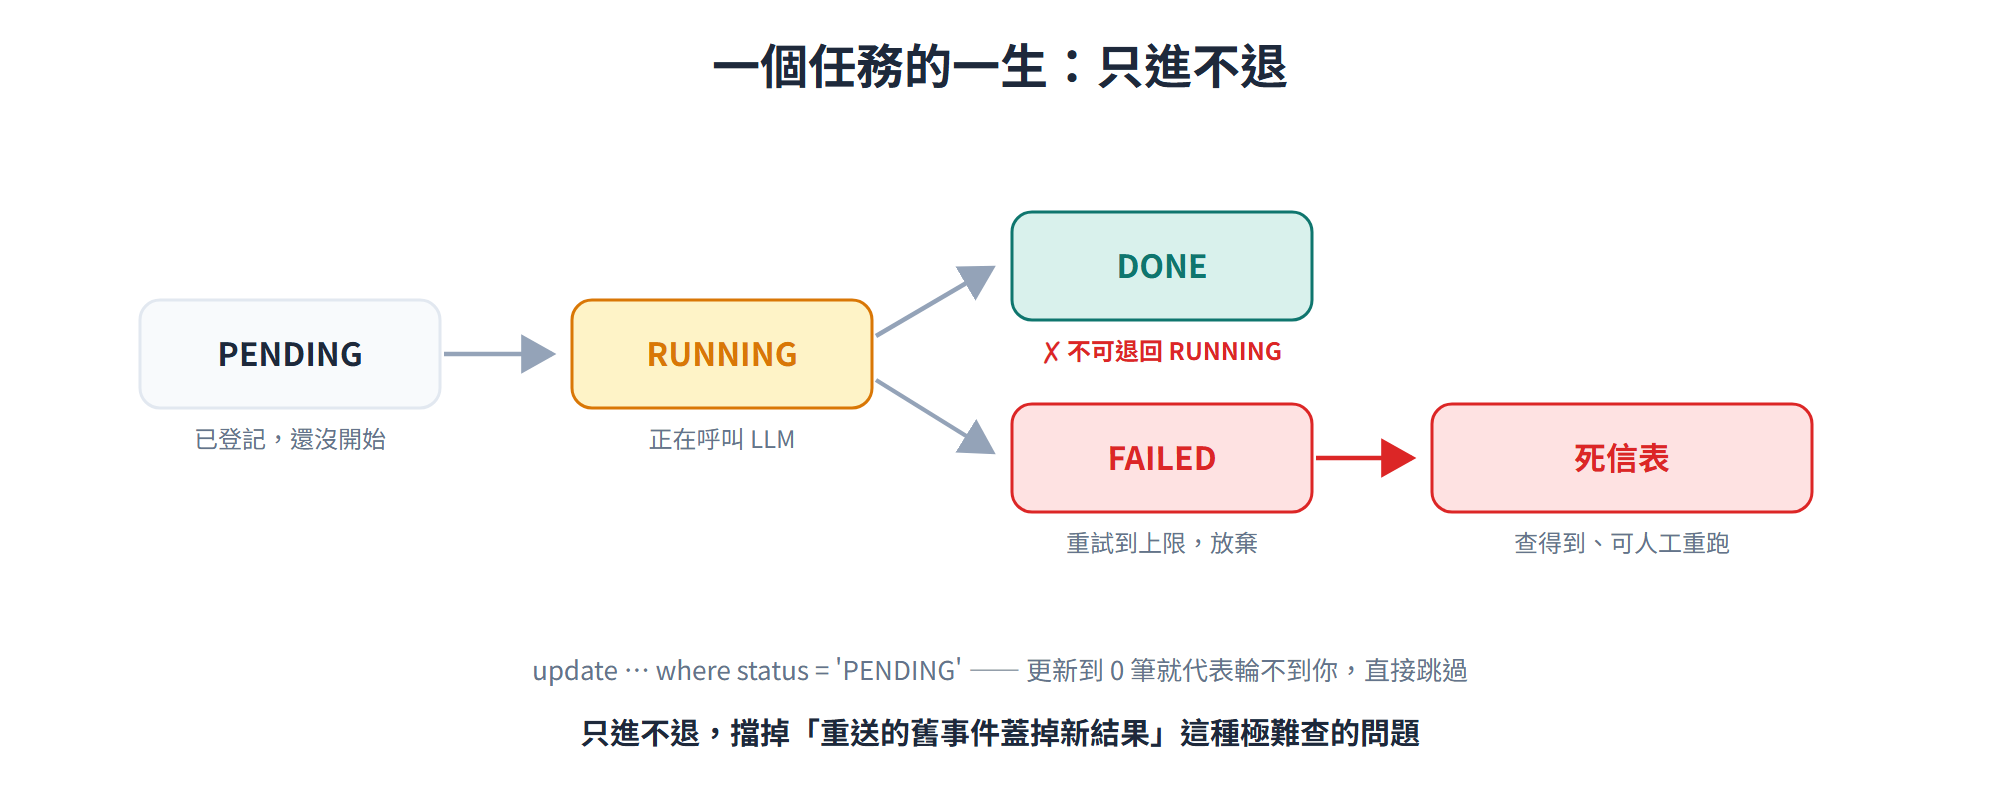
四個狀態,一條路徑:
- PENDING:已登記,還沒開始
- RUNNING:正在呼叫 LLM
- DONE:成功了
- FAILED:重試到上限,放棄了
關鍵原則是只進不退。已經 DONE 的任務不可以再被改回 RUNNING——這條規則會擋掉「重送的舊事件把新結果蓋掉」這類極難查的問題。實作上就是在更新時加條件:
update event_tasks set status = 'RUNNING'
 where event_id = ? and status = 'PENDING'
更新到 0 筆,就代表這個事件不該由你處理,直接跳過。
二、把狀態送到畫面上
有了狀態,前端就有東西可問了。最簡單的做法是輪詢:畫面每兩秒問一次「好了沒」。
但這個系列的讀者應該記得 009 期——這正是 SSE 的主場:一條不掛斷的 HTTP,伺服器有進度就推一次。
@GetMapping(value = "/api/customers/{id}/summary-status",
            produces = MediaType.TEXT_EVENT_STREAM_VALUE)
public SseEmitter status(@PathVariable Long id) {
    SseEmitter emitter = new SseEmitter(60_000L);   // 一分鐘沒結果就讓前端重連
    statusBroadcaster.register(id, emitter);
    return emitter;
}
然後在狀態每次變更的地方推一則事件出去。前端收到 DONE 就把摘要抓回來、收到 FAILED 就顯示錯誤與重試按鈕。
這裡有個很容易忽略的細節:連線建立的當下要先推一次目前狀態。否則使用者重新整理頁面時,如果任務早就跑完了,SSE 之後不會再有任何事件,畫面就會永遠停在「處理中」。
三、失敗要退,但不能退到負數
呼叫 LLM 會失敗——限流、逾時、回傳格式不對。失敗就重試,但不能立刻重試(對方正在喘氣,你馬上再打一次只會更糟)。
標準做法是指數退避:每次失敗就把等待時間加倍,並且設上限。
private static final long BASE_MS = 1000;
private static final long MAX_MS  = 30_000;

/** 指數退避:先把指數夾在安全範圍,再位移 */
long backoffMillis(int attempt) {
    int safe = Math.min(attempt, 30);
    long delay = BASE_MS << (safe - 1);
    return Math.min(delay, MAX_MS);
}
實測前八次:
B1 退避序列 1s→2s→4s→8s→16s→30s(碰上限後維持)
   實際=[1000, 2000, 4000, 8000, 16000, 30000, 30000, 30000]
那個 Math.min(attempt, 30) 看起來多餘,其實是整段程式最重要的一行。
如果沒有它,直接寫 BASE_MS * (1L << (attempt - 1)),當 attempts 一路累加上去,位移就會溢位:
B2 反例——沒夾住指數時退避會歸零或變負(等於完全不等)
   backoffUnsafe(55)=-432345564227567616 / backoffUnsafe(64)=0 毫秒
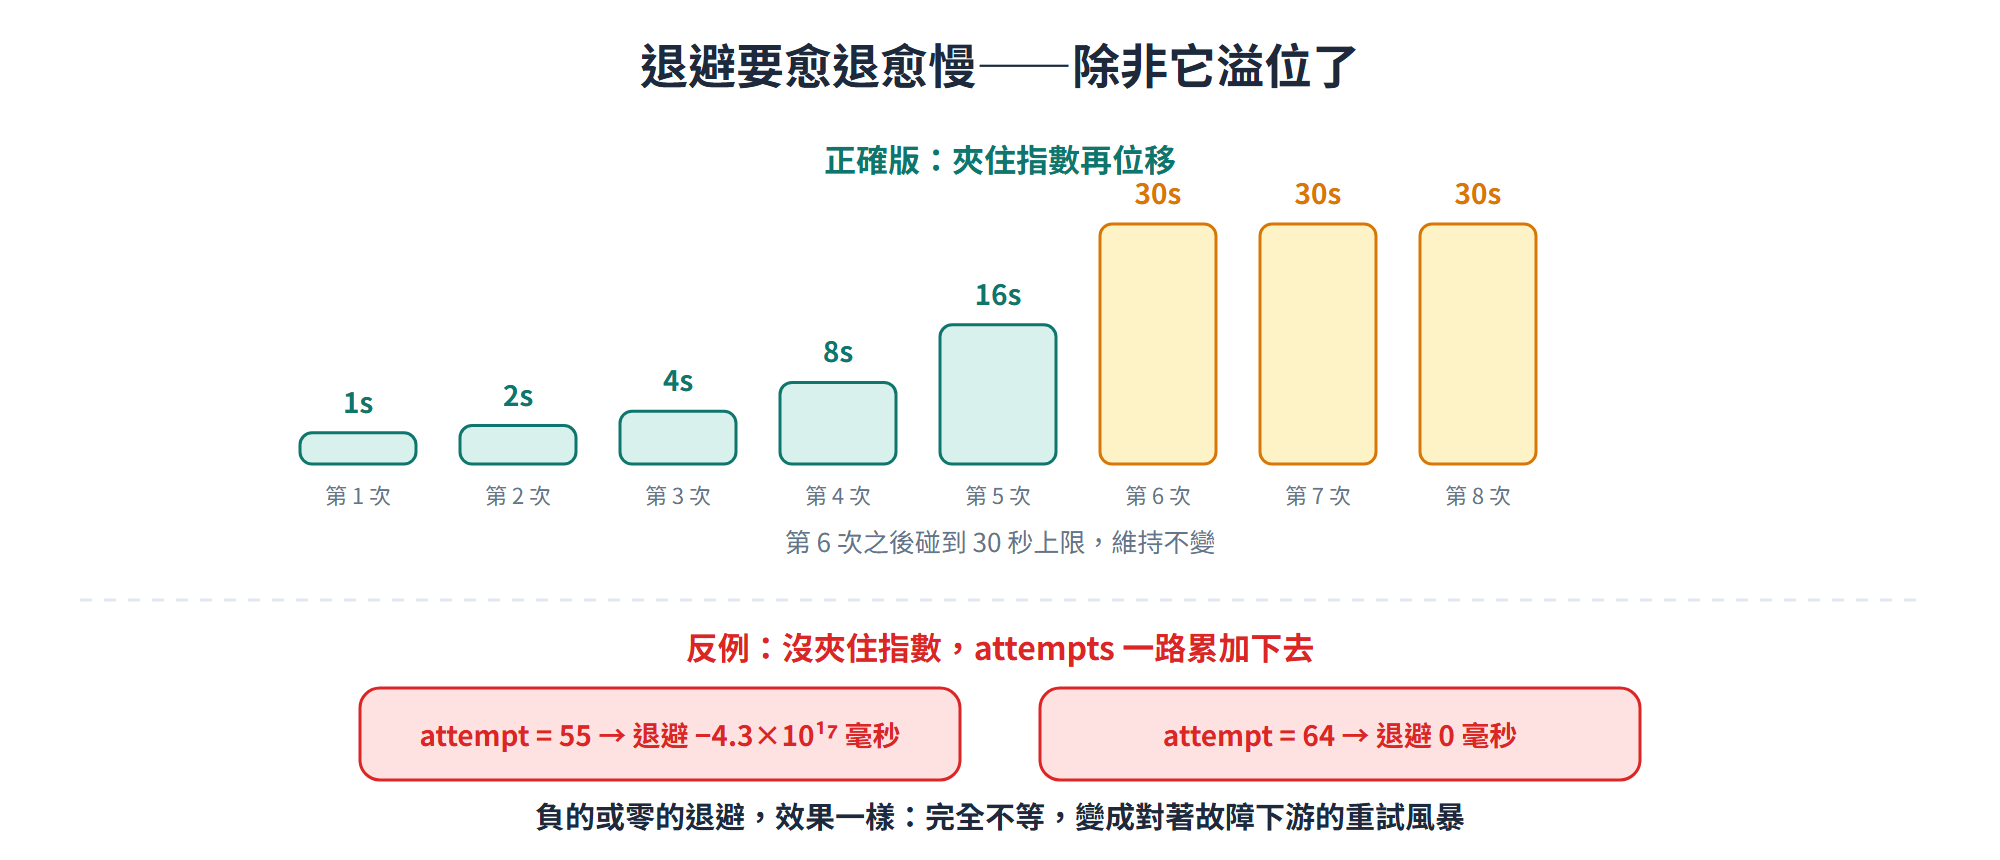
負的退避、零的退避,效果一樣:完全不等,立刻重試。你以為自己寫了一個愈退愈慢的保護,實際上它會在某個時間點突然變成全速重試風暴——而且是對著一個已經在出問題的下游。
夾住之後就穩定了:
B3 正確版同樣的 attempt 仍回傳上限,不會歸零或變負
   backoffMillis(55)=30000 / backoffMillis(64)=30000 毫秒
(順帶一提:如果你有設重試上限——下一段就要講——attempts 根本不會長到 55。這兩件事是互相保護的:上限擋住了溢位,夾指數則擋住「有人不小心把上限拿掉」的那一天。)
四、死信:承認放棄,而不是無限重試
重試不能永遠試下去。試到某個次數還是失敗,就該停手,把它搬到一個專門的地方:
if (attempts >= MAX_ATTEMPTS) {
    jdbc.update("insert into dead_letters(event_id, attempts, last_error) values (?, ?, ?)",
                eventId, attempts, lastError);
    jdbc.update("delete from event_tasks where event_id = ?", eventId);
}
實測(上限設 3 次):
B4 重試達上限後移入死信,且不再被撈出
   待處理=0 / 死信=1 / 死信中記錄的嘗試次數=3
死信表的價值不在於「存放垃圾」,而在於它把一件事變成看得見的:
- 有幾筆任務徹底失敗了?
select count(*) from dead_letters - 為什麼失敗?
last_error裡有 - 誰受影響?
event_id查得回去
沒有死信表的系統,失敗的任務要嘛無限重試(消耗資源、洗版 log),要嘛安靜消失。兩種都不好,因為你不會知道它發生過。
這也呼應了 E1 講 @Async 例外被吞掉時說的那句話:例外沒有消失,只是換了去處。死信表就是替它準備一個你會去看的去處。
最後一步是人:死信不該只是躺在那裡。後台給一個列表、一顆「重新處理」按鈕,讓人看過原因之後決定要不要再跑一次。自動化處理不了的事,就明確地交給人——這比假裝系統全自動要誠實得多。
🤖 檢查自己專案的非同步任務有沒有這三層,可以把這句丟給 AI:
找出這個專案裡所有非同步執行的任務(@Async、訊息佇列消費者、排程)。
逐一回答:
1. 這個任務有沒有狀態紀錄?使用者或後台查得到「現在跑到哪」嗎?
2. 失敗時有沒有重試?重試間隔是固定的還是指數退避?有沒有上限?
3. 重試到上限之後,失敗的任務去了哪裡?有沒有地方可以查、可以人工重跑?
把三項都缺的標為高風險。先不要改程式碼。
下期預告
系列走到這裡,事件的路已經完整了:送得出去、收得下來、回得了前端。
最後一期要換個角度看同一件事。
前幾期我們一直在講「怎麼要求 AI 交出可以被審查的產物」。但反過來——Agent 自己跑的每一步,誰來審查?
它讀了哪些資料、用了哪個提示、呼叫了哪些工具、花了多少 token、為什麼最後給出這個答案?如果客戶問「這份摘要是怎麼來的」,你答得出來嗎?
下期,也是這個系列的最後一期:把事件流變成 Agent 的稽核軌跡。
—— 凱文大叔
延伸閱讀:
- Spring Framework:Asynchronous execution 與 TaskExecutor 設定
- AWS Builders' Library:Timeouts, retries, and backoff with jitter